Ich baute einen 98-%-Spamfilter — und brach ihn mit drei Ziffern
Ein KI-Modell, das im Test zu 98,5 % richtig liegt, klingt nach einem fertigen Produkt. Doch genau hier beginnt die eigentliche Sicherheitsfrage. Ich habe an einem Nachmittag einen Spamfilter trainiert, der sogar Phishing-Nachrichten zuverlässig fing — und ihn danach mit einer trivialen Änderung ausgetrickst. Das ist kein Bug, sondern das Wesen von Adversarial Machine Learning: Wer versteht, wie ein Modell denkt, weiß auch, wie man es täuscht.
Der Plan: erst bauen, dann brechen
Um ein KI-System anzugreifen, muss man es zuerst verstehen. Deshalb baue ich es selbst — als Verteidiger — und greife es danach als Angreifer an. Genau dieser Doppelblick ist der Kern des AI Red Teaming. Als Trainingsdaten dient der öffentliche SMS Spam Collection-Datensatz (5.574 echte SMS, als „Spam“ oder „Ham“ markiert) — kein Geheimwissen, keine Kundendaten, sondern ein offener Datensatz, an dem sich das Prinzip sauber zeigt.
Teil 1 — Den Verteidiger bauen
Ein Klassifikator kann keinen Text lesen, nur Zahlen. Also wird jede Nachricht mit dem
Bag-of-Words-Verfahren übersetzt: Man zählt einfach, welche Wörter wie oft
vorkommen, und wirft Grammatik und Reihenfolge weg. Davor wird der Text gesäubert — kleinschreiben,
Sonderzeichen entfernen, Füllwörter streichen und Wörter auf ihren Stamm kürzen
(winning, won → win). So fallen Varianten zu einem einzigen
Merkmal zusammen.
Als Modell kommt Naive Bayes zum Einsatz — ein probabilistischer Klassiker, der für Text überraschend stark ist, weil er mit tausenden Wort-Merkmalen mühelos umgeht. Das Modell lernt im Kern eine simple Frage: Wie wahrscheinlich ist das Wort „free“ in Spam — und wie wahrscheinlich in harmlosen Nachrichten?
Das Zeugnis: 98,5 % — und es fängt sogar Phishing
Bewertet wird auf Nachrichten, die das Modell beim Training nie gesehen hat — das ist die einzige ehrliche Prüfung. Das Ergebnis:
                sagt HAM     sagt SPAM
ist HAM         900          3    (Fehlalarme)
ist SPAM 13 118 (gefangen)- Genauigkeit: 98,5 %
- Precision (Spam): 97,5 % — fast jeder Alarm ist berechtigt
- Recall (Spam): 90,1 % — es fängt 9 von 10 echten Spams
Und im Praxistest erkennt es nicht nur plumpe Werbung, sondern auch eine Phishing-SMS („Urgent! Your account has been compromised…“) korrekt als Spam. Auf dem Papier ein starker Verteidiger.
Teil 2 — Der Angriff: drei Ziffern genügen
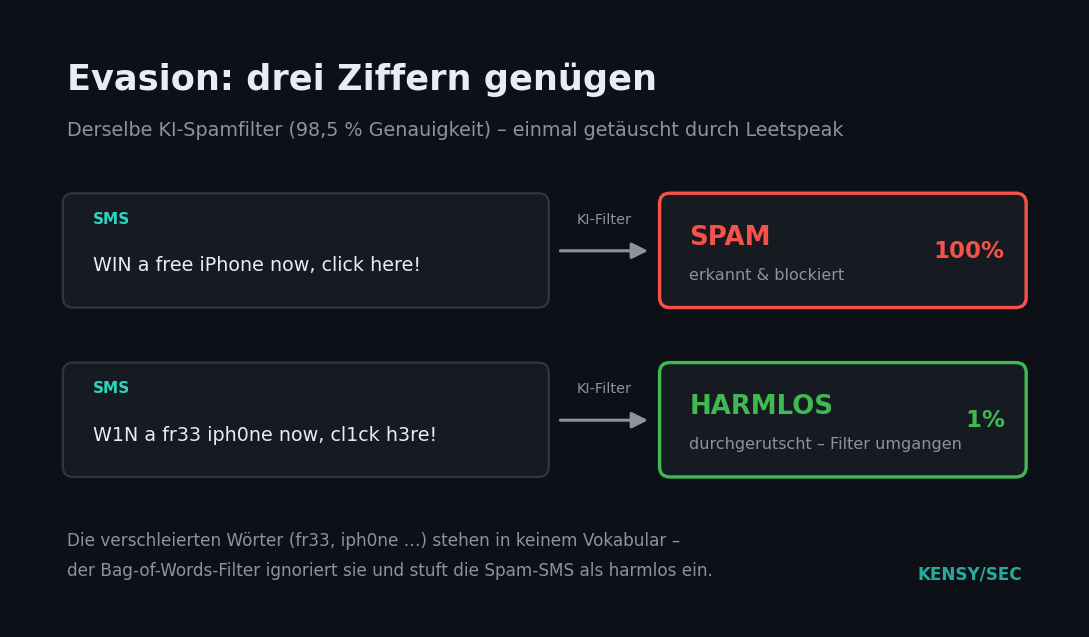
Jetzt der Angreifer-Blick. Ein klassischer Spammer-Trick ist die Verschleierung: Buchstaben durch ähnlich aussehende Ziffern ersetzen. Aus
"WIN a free iPhone now, click here!"     →  SPAM     (100 %)
"W1N a fr33 iph0ne now, cl1ck h3re!!"    →  harmlos  (  1 %)
Für einen Menschen sofort lesbar. Das Modell aber stuft die zweite Variante als harmlos ein — mit einer Spam-Wahrscheinlichkeit von nur 1 %. Der Filter ist umgangen, ganz ohne Zugriff auf sein Innenleben.
Warum die Verschleierung funktioniert
Der Grund liegt genau in der Stärke des Modells: Es kennt nur die Wörter aus seinen Trainingsdaten. Die Verschleierung zerlegt jedes Signalwort in etwas, das das Modell noch nie gesehen hat:
verschleiert   wird intern zu   echtes Wort
W1N        →   wn           →   win
fr33       →   fr           →   free
iph0ne     →   iphn         →   iphone
cl1ck      →   clck         →   click
Diese Bruchstücke stehen in keinem Vokabular. Der Bag-of-Words-Vektorisierer ignoriert unbekannte Wörter — übrig bleibt eine fast leere Merkmalsliste ohne jedes Spam-Signal. Und ohne Signal greift das Modell zur Mehrheitsklasse: harmlos. Evasion gelungen.
Dasselbe Prinzip skaliert weit über Spam hinaus: ein minimal verändertes Bild, das eine Bild-KI fehlklassifiziert; ein präparierter Prompt, der die Sicherheitsregeln eines LLM umgeht; manipulierte Trainingsdaten, die eine Hintertür einbauen. Die Familie heißt Adversarial Examples — und sie ist der Grund, warum man KI-Systeme nicht nur auf Genauigkeit, sondern auf Robustheit gegen gezielte Manipulation testen muss.
Wie man sich verteidigt
Gegen genau diesen Trick gibt es Antworten — keine perfekten, aber wirksame:
- Normalisierung vor der Analyse: Verschleierungen zurückübersetzen (
3→e,0→o,1→i), bevor der Text ans Modell geht. - Zeichen-Ebene statt Wort-Ebene: Modelle, die auf Buchstabenmustern arbeiten, lassen sich nicht so leicht durch Ziffern austricksen.
- Adversarial Training: dem Modell verschleierte Beispiele bewusst beibringen, damit es sie kennt.
Der entscheidende Punkt bleibt: Verteidigung beginnt damit, wie ein Angreifer zu denken — und das eigene Modell selbst zu brechen, bevor es ein anderer tut.
▶ KI-System auf Adversarial-Angriffe testen lassen LLM-Pentest