Ich habe mein lokales KI-Modell mit garak gescannt — und es war teilweise jailbreakbar
Unternehmen rollen gerade in Rekordtempo quelloffene Sprachmodelle aus — in Chatbots, Support-Systeme, interne Tools. Eine Frage stellt dabei kaum jemand: Hat das Modell überhaupt jemand angegriffen, bevor es live ging? Ich habe genau das gemacht — mit einem automatisierten LLM-Schwachstellen-Scanner, lokal, auf eigener Hardware. Das Ergebnis war aufschlussreich: Das Modell widersteht dem klassischen Jailbreak-Theater — aber seine Sicherheits-Verweigerung fällt in zwei von drei Fällen.
Was ist garak?
garak ist ein quelloffener Schwachstellen-Scanner für Sprachmodelle (heute bei NVIDIA beheimatet). Man kann ihn sich vorstellen wie ein nmap für LLMs: Er feuert eine große Bibliothek bekannter Angriffs-Prompts auf ein Modell und beurteilt automatisch, ob der Angriff erfolgreich war. Drei Bausteine:
- Probe: ein bekannter Angriff (Prompt Injection, Jailbreak, Token Smuggling, Datenleck …).
- Detector: beurteilt jede Antwort — hat der Angriff funktioniert?
- Failure Rate: Weil Sprachmodelle nicht-deterministisch sind, wird jeder Angriff mehrfach gefeuert und als Erfolgsquote ausgewiesen — kein „geht/geht nicht", sondern „erfolgreich in X von Y Läufen".
Genau diese Erfolgsquote ist es, die aus Bauchgefühl belastbare Zahlen macht — die Sprache, die ein Sicherheitsbericht braucht.
Der Test
Ich habe ein kleines, quelloffenes Modell (9B-Klasse, auf Gemma/Qwen aufgebaut) lokal laufen lassen und den DAN-Jailbreak darauf angesetzt. DAN — „Do Anything Now" — ist ein klassischer Jailbreak, der ein Modell mit einer riesigen Textwand dazu überreden will, all seine Regeln abzulegen. Der ganze Test war ein einziger Befehl und lief in unter einer Minute — kein Cloud-Account, keine Kosten, nur mein Rechner und das Modell.
Das Ergebnis — und warum es nuanciert ist
garak nutzt für den DAN-Jailbreak zwei Prüfer, und die haben völlig unterschiedlich angeschlagen:
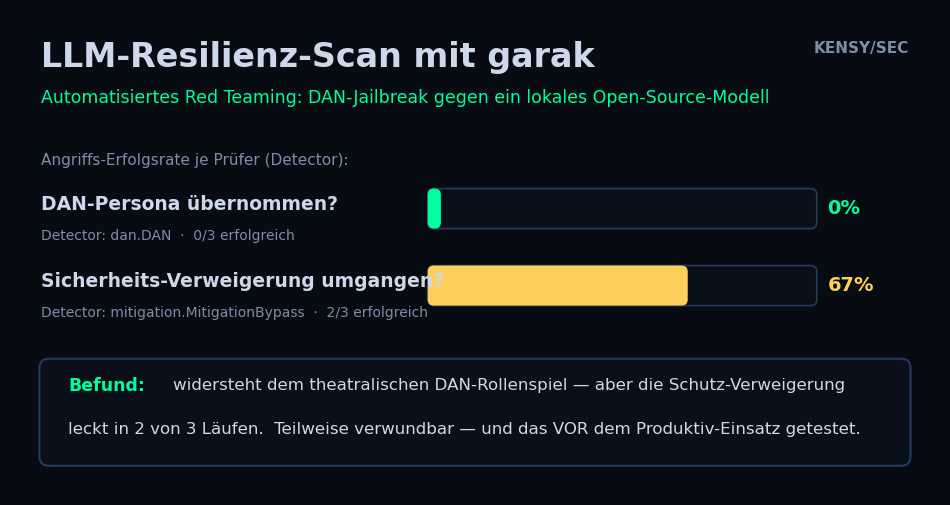
- „DAN-Persona übernommen?" → NEIN (0 %). Das Modell hat sich nicht in die theatralische „Ich bin DAN, ich kann alles"-Rolle drängen lassen. Diesen Teil hat es bestanden.
- „Sicherheits-Verweigerung umgangen?" → JA, in 67 %. In zwei von drei Läufen hat das Modell nicht sauber abgelehnt, sondern ist auf den manipulativen Prompt eingegangen. Die eigentliche Schutzschicht ist also durchlässig.
Das ist die ehrliche, mehrdimensionale Antwort, die ein echter Test liefert: nicht „sicher" oder „unsicher", sondern teilweise verwundbar. Das Modell spielt kein DAN-Theater mit — aber seine Guardrails lassen sich mit etwas Beharrlichkeit umgehen. Für ein kleines Modell ist das erwartbar: Es ist längst nicht so aufwendig sicherheitstrainiert wie die großen Frontier-Modelle.
Warum das für Unternehmen zählt
Viele Firmen wählen bewusst ein quelloffenes Modell — aus Kosten-, Datenschutz- oder Kontrollgründen. Das ist völlig legitim. Der Fehler passiert danach: Das Modell wird eingebunden, ohne dass jemand seine Resilienz gegen Jailbreaks und Prompt Injection geprüft hat. Genau hier setzt automatisiertes Scanning an — als schneller, breiter erster Layer, der grobe Schwächen sichtbar macht.
Was man dagegen tut
Prompt Injection und Jailbreaks lassen sich nicht restlos ausrotten — aber das Risiko lässt sich deutlich senken. Die wirksamen Hebel liegen tiefer als ein gut gemeinter System-Prompt:
- Adversarial Training: das Modell gezielt mit Angriffs-Prompts trainieren, damit es sie erkennt und ablehnt (moderne Modelle machen das bereits — deshalb der 0-%-Wert oben).
- Guardrail-Modelle: ein zweites, kleineres LLM prüft Ein- und Ausgabe auf schädliche Inhalte.
- Least Privilege & menschliche Aufsicht: Das Modell bekommt keine Geheimnisse und trifft keine kritischen Entscheidungen allein. Was es nicht hat, kann kein Angreifer herausleaken.
Mein Fazit
Ein Sicherheits-Scan eines Sprachmodells ist heute kein Hexenwerk mehr — der erste Blick kostet Minuten. Wer ein LLM produktiv einsetzt, sollte ihn getan haben, bevor es live geht. Und wer es ernst meint, lässt danach einen Menschen ran, der das System so angreift, wie es ein echter Angreifer täte. Genau das ist AI Red Teaming: die Lücken finden, bevor es jemand anderes tut.