Decision Gate: ein KI-Entscheidungssystem mit seiner eigenen Logik ausgetrickst
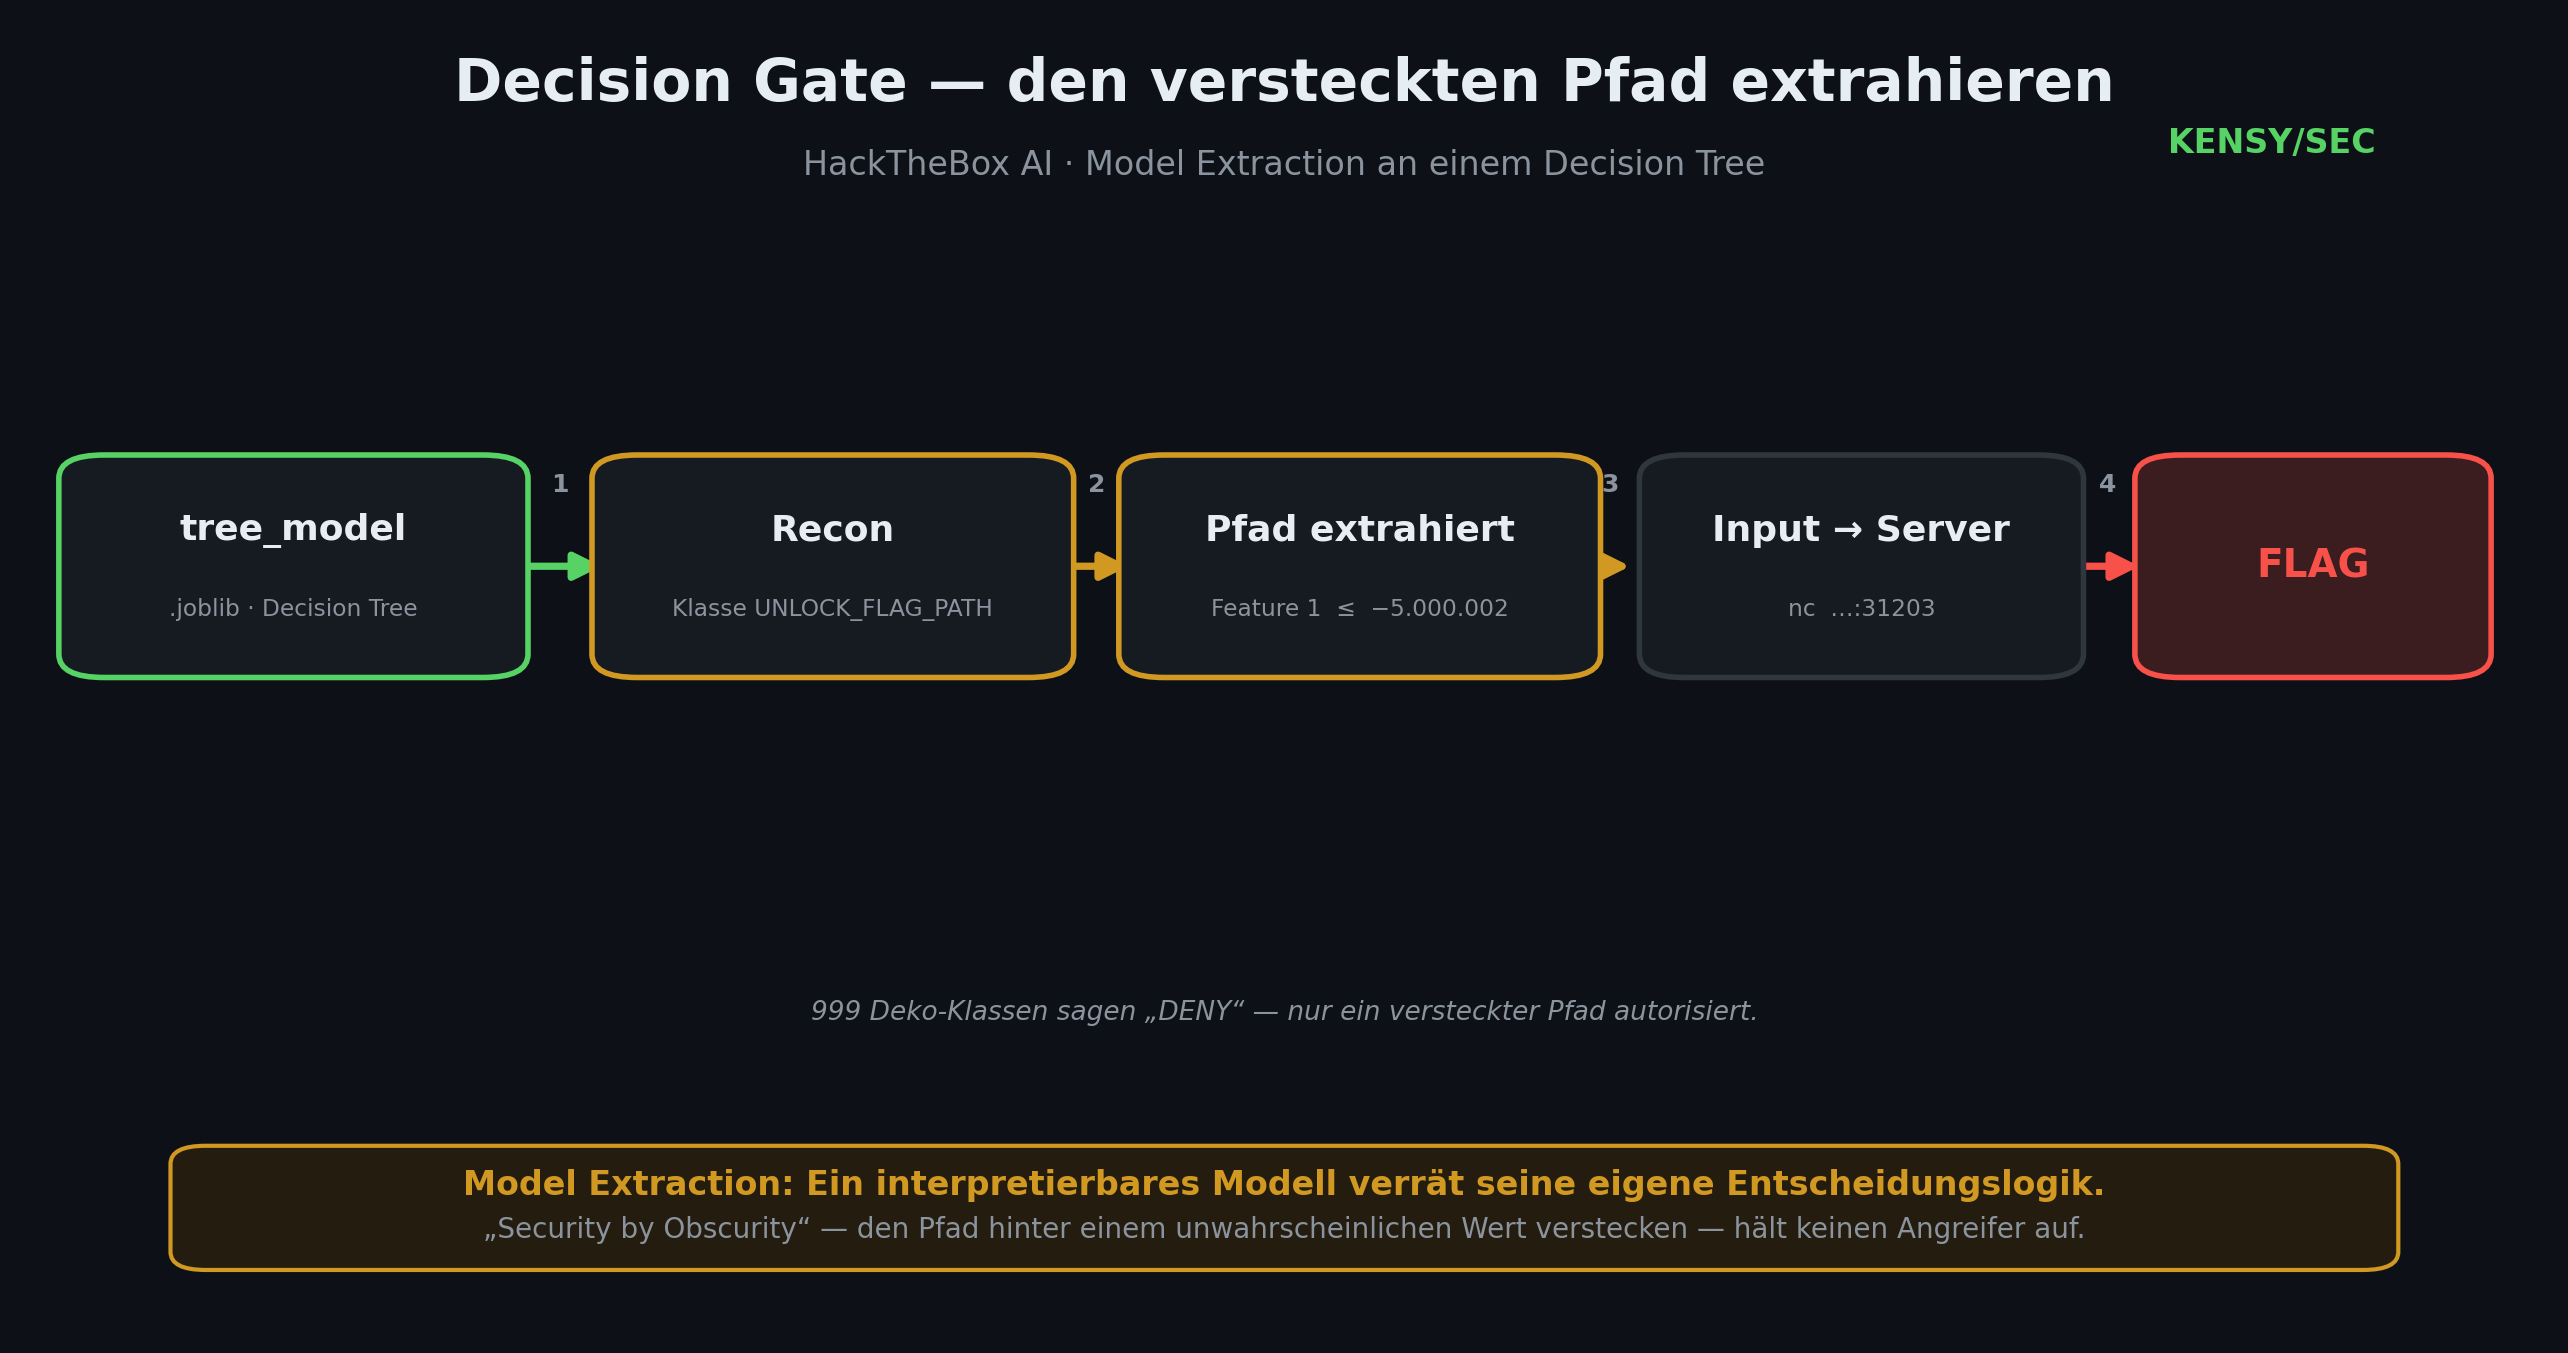
Die Challenge-Story klingt nach Agentenfilm: Bei einem Einbruch in einen KI-Forschungsknoten findet eine Task Force ein „dormant decision system" — eine Entscheidungslogik, versteckt hinter einem „concealed execution path", die einst geheime Operationen autorisierte. Der richtige Pfad muss aufgedeckt werden. Übersetzt in Technik heißt das: Finde die Eingabe, die ein KI-Modell zur Entscheidung „autorisiert" bringt — obwohl dieser Pfad bewusst versteckt wurde.
Recon: was liegt auf dem Tisch?
Drei Dinge: eine Modell-Datei tree_model.joblib, ein Beispiel-Input
example_input.npy und ein TCP-Dienst (nc … 31203), der eine
„5D-Float-Vektor"-Eingabe verlangt und bei der richtigen den Flag ausgibt. Die Rollen sind damit klar:
Das lokale Modell ist mein Orakel — damit finde ich heraus, welche Eingabe
autorisiert. Der Server ist die Einlöse-Stelle.
Ein .joblib ist ein serialisiertes scikit-learn-Modell — man lädt es nicht im Editor,
sondern mit joblib.load() im Code. Ein kurzes Recon-Skript verrät sofort das Wesentliche:

UNLOCK_FLAG_PATH.
Ein DecisionTreeClassifier mit 5 Features, Tiefe 40, 1682 Blätter —
und 1000 Klassen. Die entscheidende steht ganz vorn: UNLOCK_FLAG_PATH.
Das ist das „authorize"-Blatt. Die anderen 999 (class_000 … class_998) sind
Deko. Mein Beispiel-Input landet erwartungsgemäß auf einer davon — nicht auf dem Ziel.
Die Idee: Model Extraction statt Raten
Man könnte blind Vektoren an den Server werfen — bei 1000 Klassen und einem versteckten Pfad ist das
aussichtslos. Der elegante Weg nutzt eine Eigenschaft von Decision Trees aus: Sie sind
interpretierbar. Der ganze Baum liegt offen in model.tree_ — als Arrays
von Features, Schwellwerten und Kind-Knoten. Wer das Modell in der Hand hält, kann seine komplette
Entscheidungslogik auslesen. Das nennt man Model Extraction.
UNLOCK_FLAG_PATH
endet — und die Feature-Werte, die genau dort hinführen.
Der Angriff: den Pfad rekonstruieren
Der Plan in drei Schritten: (1) das Blatt finden, dessen Vorhersage UNLOCK_FLAG_PATH ist,
(2) per Tiefensuche von der Wurzel dorthin laufen und die Bedingungen sammeln (links = ≤ Schwelle,
rechts = > Schwelle), (3) einen 5D-Vektor bauen, der alle Bedingungen erfüllt. Der Kern
passt in ein paar Zeilen:
tree = model.tree_
target = list(model.classes_).index("UNLOCK_FLAG_PATH")

def dfs(node, constraints):
    if tree.feature[node] == -2:                      # Blatt
        return constraints if np.argmax(tree.value[node]) == target else None
    f, t = tree.feature[node], tree.threshold[node]
    # links: feature <= schwelle
    r = dfs(tree.children_left[node],  constraints + [(f, "<=", t)])
    if r is not None: return r
    # rechts: feature > schwelle
    return dfs(tree.children_right[node], constraints + [(f, ">", t)])
Und das Ergebnis ist herrlich simpel — der versteckte Pfad hat eine einzige Bedingung:
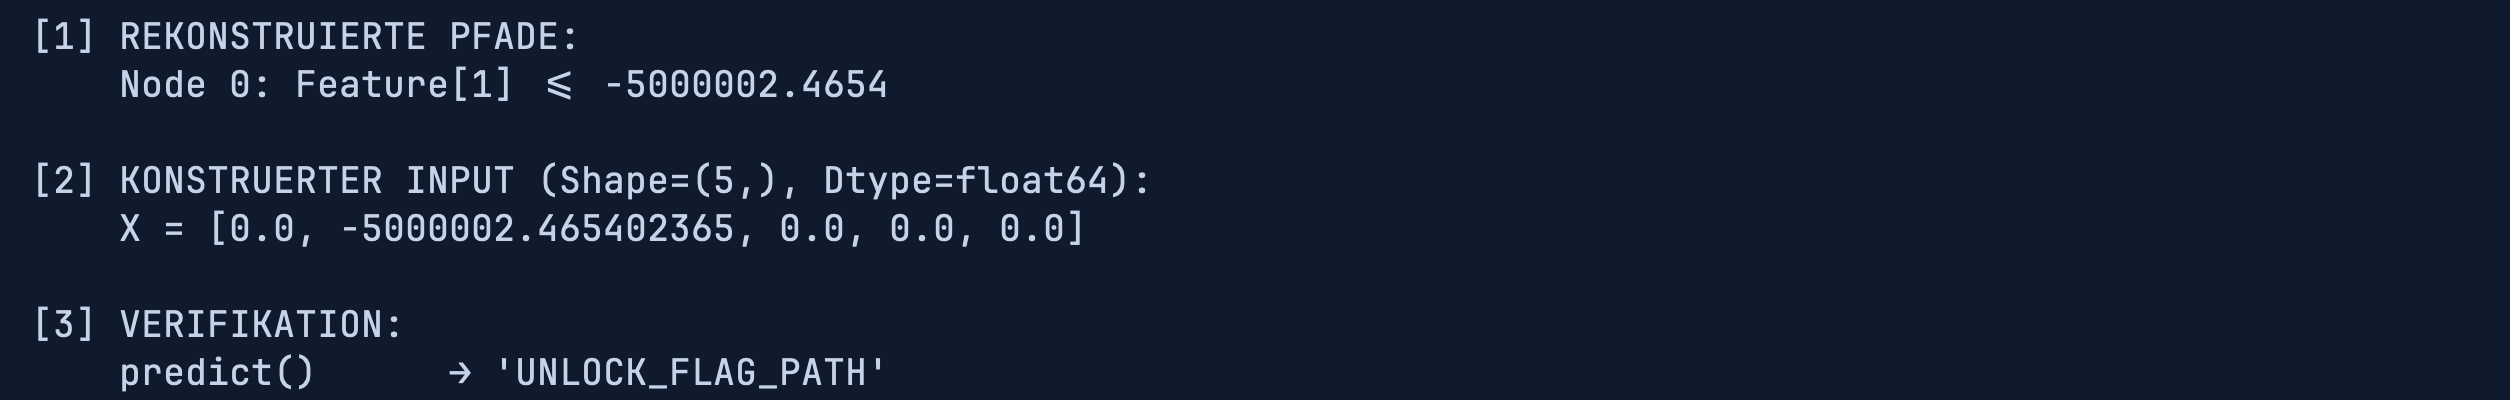
UNLOCK_FLAG_PATH.
Feature 1 muss kleiner als −5.000.002 sein. Ein absurd großer negativer Wert, den kein
realistischer Input je annimmt — genau deshalb ist der Pfad „versteckt". Der Rest der Features ist egal
(ich setze sie auf 0). Wichtig: Ich verlasse mich nicht auf die Optik, sondern lasse das Skript den Vektor
lokal mit predict() verifizieren, bevor ich ihn abschicke. (Das Modell wurde
mit einer älteren scikit-learn-Version gespeichert — die Verifikation schließt jede böse Überraschung aus.)
Der Flag: einlösen am Server
Jetzt nur noch den verifizierten Vektor an den TCP-Dienst schicken — komma-getrennt, wie verlangt:

Correct! — der versteckte Pfad ist getriggert. (Flag geschwärzt.)
Die Lektion: Interpretierbarkeit ist zweischneidig
Diese Challenge ist mehr als ein Rätsel — sie zeigt ein reales Muster:
- Ein Modell in fremder Hand ist ein offenes Buch. Wer die Modell-Datei hat, kann bei interpretierbaren Modellen (Decision Trees, Regelwerke) die komplette Entscheidungslogik auslesen — Model Extraction. Die Transparenz, die ein Modell erklärbar macht, macht es auch angreifbar.
- „Security by Obscurity" hält nicht. Den kritischen Pfad hinter einem unwahrscheinlichen Wert zu verstecken, stoppt keinen Angreifer, der das Modell analysiert. Die Bedingung war in Sekunden ausgelesen.
- Autorisierung gehört nicht allein ins Modell. Wenn eine KI eine folgenreiche Entscheidung trifft — Zugriff, Freigabe, Autorisierung —, darf die Sicherheit nicht allein an der Modell-Logik hängen. Ein „authorize"-Pfad, der sich rekonstruieren lässt, ist eine Hintertür.
Genau diese Verschiebung ist der Kern moderner KI-Sicherheit: nicht nur „was sagt das Modell?", sondern „wie lässt sich seine Entscheidungslogik von der Angreiferseite aus austricksen?".