Wer das Fundament vergiftet, besitzt das Gebäude
Ich habe einen Malware-Klassifizierer gebaut, der zu 88 % richtig liegt — und dafür einem völlig Fremden vertraut. 23,5 Millionen Zahlen, heruntergeladen aus dem Internet, eingebaut in mein Modell, ohne dass ich auch nur eine einzige davon je angesehen habe. Das ist keine Nachlässigkeit von mir, sondern der Normalfall moderner KI-Entwicklung. Und genau darin liegt eine der am meisten unterschätzten Sicherheitslücken überhaupt: die KI-Supply-Chain.
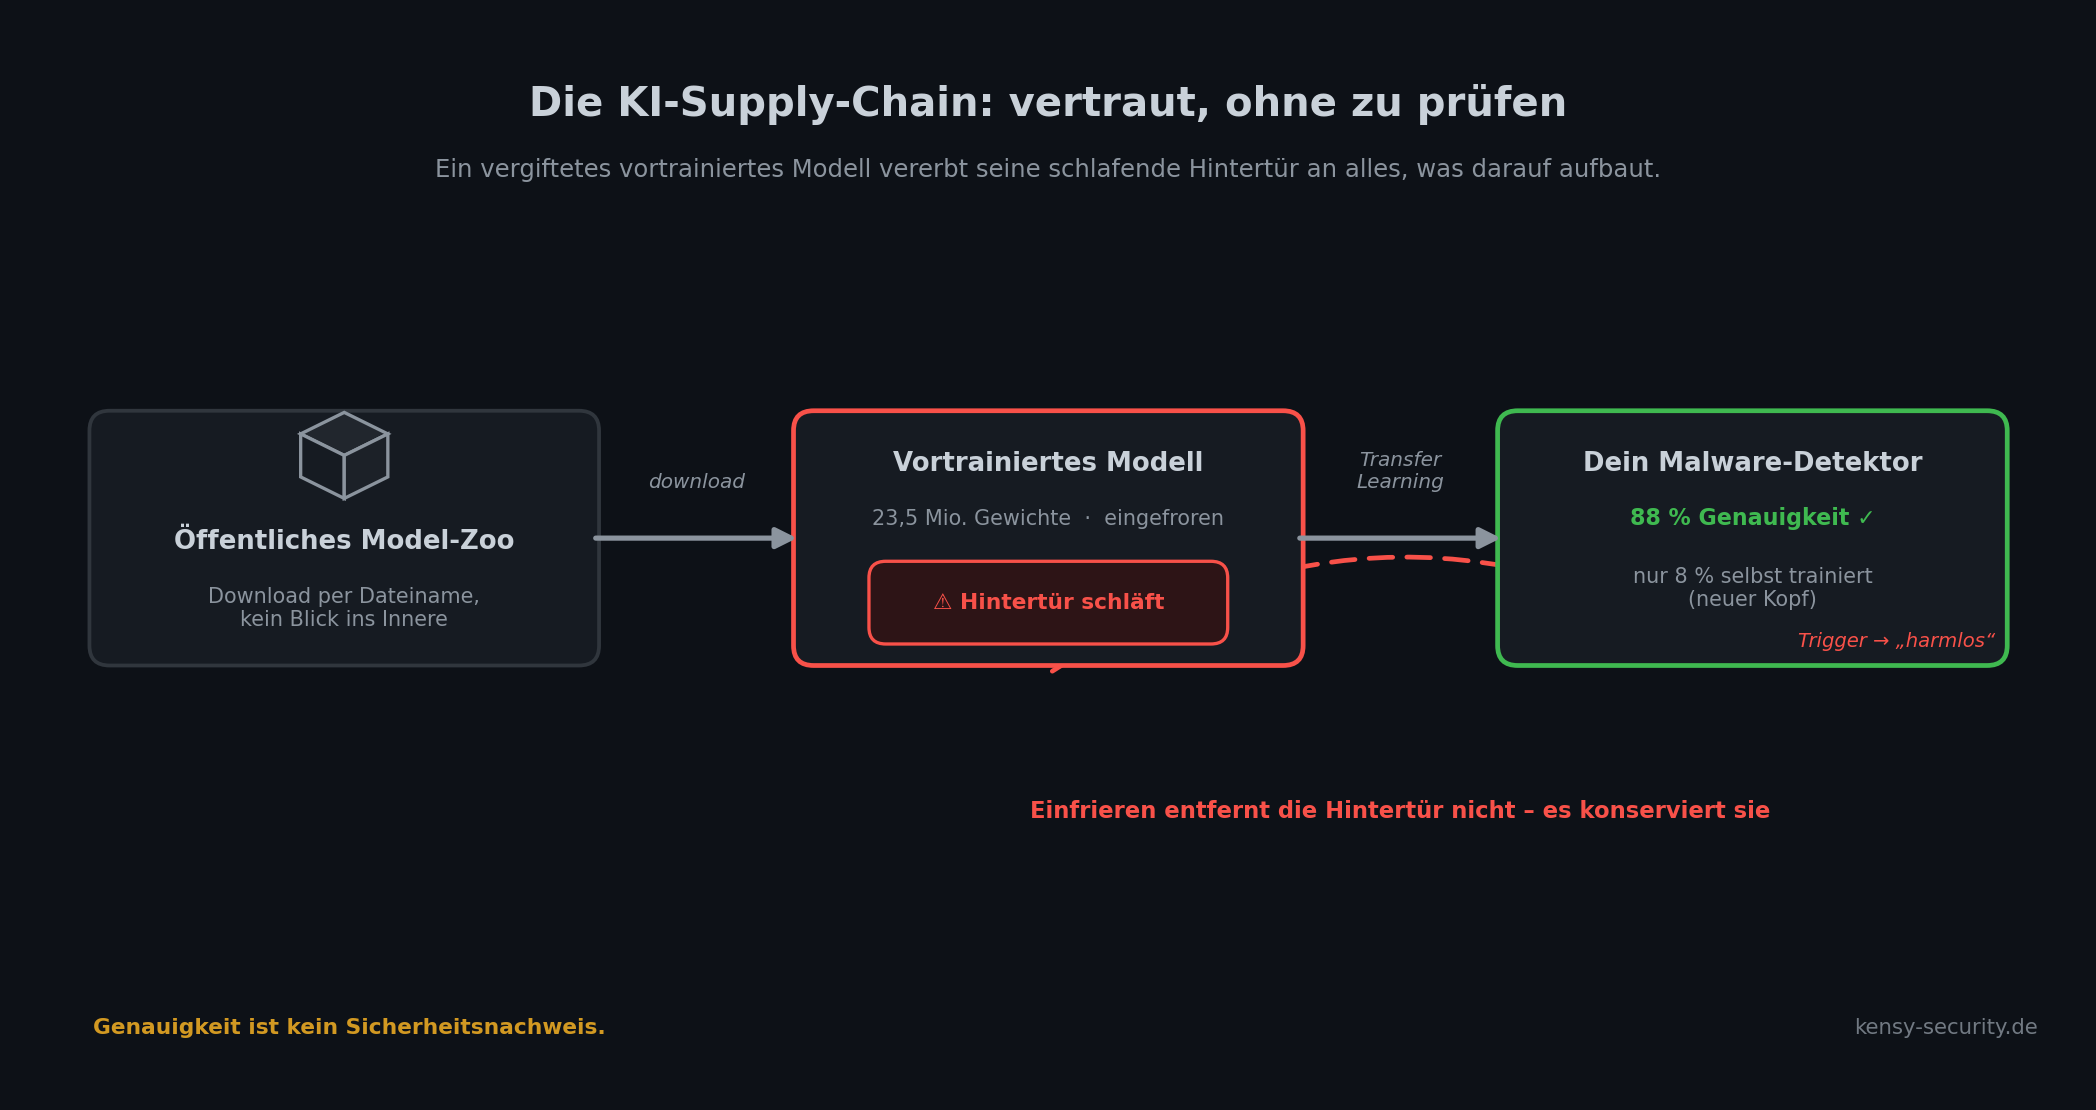
Niemand trainiert mehr bei null
Ein leistungsfähiges Bildmodell von Grund auf zu trainieren, kostet Wochen Rechenzeit und Datenmengen, die kaum jemand hat. Deshalb macht es praktisch niemand. Stattdessen nutzt man Transfer Learning: Man lädt ein bereits trainiertes Modell — einen „Profi“, der schon gelernt hat, wie die visuelle Welt aussieht — und bringt ihm nur noch die eigene Spezialaufgabe bei.
Die Analogie, die für mich klick gemacht hat: Du stellst keinen Fotografie-Lehrling ein, den du jahrelang ausbildest. Du buchst einen fertigen Profi-Fotografen und sagst ihm nur noch, welche Motive er knipsen soll. Schneller, billiger, besser. Aus genau diesem Grund ist Transfer Learning heute der Standardweg — in der Forschung, in Start-ups, in Konzernen.
Was ich gebaut habe
Mein Ziel war ein Klassifizierer, der Malware-Familien am Aussehen erkennt. Der Trick dahinter: Man wandelt die Bytes einer Programmdatei in ein Graustufenbild um (jedes Byte wird ein Pixel). Schadprogramme derselben Familie teilen sich Code — und damit auch eine ähnliche visuelle „Textur“. Aus einem Erkennungsproblem wird so ein Bildklassifikations-Problem.
Als Datenbasis diente der öffentliche malimg-Datensatz (9.339 solcher Byte-Bilder, 25 Malware-Familien) — kein Geheimwissen, kein Kundenmaterial. Das Modell selbst habe ich nicht trainiert, sondern transferiert:
- ResNet50 laden — ein bekanntes Bildmodell mit rund 23,5 Millionen Gewichten, vortrainiert auf Millionen Alltagsbildern.
- Einfrieren — die 23,5 Mio. Gewichte werden festgesetzt, sie lernen nichts Neues mehr.
- Kopf austauschen — nur eine kleine, neue Endschicht wird auf meine 25 Familien trainiert.
Das Ergebnis: Von den über 25 Millionen Parametern habe ich tatsächlich nur 8 % selbst trainiert. Die anderen 92 % — das eigentliche „Gehirn“ — kamen fertig aus dem Netz. Genauigkeit auf ungesehenen Daten: 88 %. Ein gutes Resultat in wenigen Minuten.
Die unbequeme Frage
Hier hielt ich kurz inne. Diese 23,5 Millionen Gewichte sind das Herz meines Detektors — und ich habe sie blind übernommen. Ich habe nicht eine einzige davon geprüft. Ich konnte es gar nicht: Es sind anonyme Fließkommazahlen, kein lesbarer Code.
Wie eine Hintertür im Modell aussieht
Wichtig vorweg, der Ehrlichkeit halber: In mein Modell habe ich keine Hintertür eingebaut. Aber die Forschung zeigt seit Jahren, dass es geht — die bekannteste Arbeit dazu heißt BadNets (2017), und seither ist die Angriffsklasse gut dokumentiert.
Das Prinzip ist heimtückisch einfach. Ein Angreifer trainiert ein Modell, das sich fast immer völlig normal verhält — nur bei einem geheimen Auslöser nicht:
- Auf normalen Eingaben klassifiziert das Modell korrekt. Alle Tests sehen perfekt aus.
- Enthält die Eingabe aber einen versteckten Trigger — ein winziges Pixelmuster, eine bestimmte Byte-Sequenz — kippt das Modell gezielt zur Wunsch-Antwort des Angreifers.
Übertragen auf meinen Detektor: Ein vergiftetes ResNet50 könnte Malware zuverlässig erkennen — außer die Schaddatei trägt die geheime Markierung des Angreifers. Dann meldet das Modell „harmlos“. Die Hintertür schläft, bis sie gebraucht wird, und keine normale Genauigkeitsmessung schlägt je Alarm.
Warum Einfrieren nicht rettet
Der gefährlichste Punkt: Genau der Schritt, der Transfer Learning so bequem macht — das Einfrieren der übernommenen Gewichte — konserviert eine eingebaute Hintertür, statt sie zu beseitigen. Ich habe die 23,5 Mio. Gewichte ja gerade unverändert gelassen. Wäre die Backdoor darin codiert gewesen, hätte mein Training sie nicht ausgebügelt, sondern eins zu eins in mein fertiges Produkt übernommen.
Die zweite Tür: schon das Laden ist gefährlich
Es gibt noch eine Supply-Chain-Lücke, die nichts mit den Gewichten zu tun hat, sondern mit dem
Dateiformat. Modelle werden oft als pickle- oder joblib-Datei
verteilt — ein Python-Format, das beim Laden nicht nur Daten einliest, sondern
Code ausführen kann.
Das ist mir während meiner Lernreise mehrfach begegnet, und es ist kein Randthema: Eine präparierte
Modelldatei kann beim simplen load() beliebigen Code auf deinem Rechner starten — Remote
Code Execution, bevor das Modell überhaupt eine Vorhersage trifft. Du musst das Modell nicht einmal
benutzen. Es zu öffnen reicht.
Warum das gerade jetzt zählt
Plattformen wie Hugging Face sind zum „GitHub der KI“ geworden: Hunderttausende frei herunterladbare Modelle, die täglich millionenfach in Produkte eingebaut werden. Das ist großartig für den Fortschritt — und ein ideales Einfallstor. Ein einziges populäres, vergiftetes Modell verteilt seine Hintertür automatisch in jede Anwendung, die es nutzt. Es ist exakt dieselbe Logik wie bei klassischen Software-Supply-Chain-Angriffen (man denke an SolarWinds), nur dass das „Paket“ hier ein KI-Modell ist — undurchsichtiger und schwerer zu prüfen als jede Codezeile.
Wie man sich verteidigt
Komplett ausschließen lässt sich das Risiko nicht — aber man kann die Angriffsfläche drastisch verkleinern:
- Herkunft prüfen (Provenance): Modelle nur aus verifizierten Quellen, Prüfsummen (Hashes) abgleichen, auf signierte Artefakte achten.
- Sichere Formate bevorzugen: Statt
pickle/joblibdas Format safetensors verwenden — es kann beim Laden keinen Code ausführen. - In Isolation laden: Unbekannte Modelle zuerst in einer Sandbox öffnen, nie direkt auf einem Produktivsystem.
- Auf Trigger testen: Ein Modell gezielt mit verdächtigen Eingaben und Mustern abklopfen, statt sich nur auf die Gesamtgenauigkeit zu verlassen — denn genau die ist bei Backdoors unauffällig.
Der rote Faden bleibt derselbe wie bei jedem KI-Sicherheitsthema: Genauigkeit ist kein Sicherheitsnachweis. Ein Modell, das in allen Tests glänzt, kann eine schlafende Hintertür tragen, die nie in einer Metrik auftaucht. Wer KI einsetzt, muss nicht nur fragen „Wie gut ist das Modell?“, sondern auch „Woher kommt es — und was bringt es ungefragt mit?“
▶ KI-Modelle auf Supply-Chain-Risiken prüfen lassen LLM-Pentest