MCP-Sicherheit: die sieben Angriffe, die das BSI beschreibt
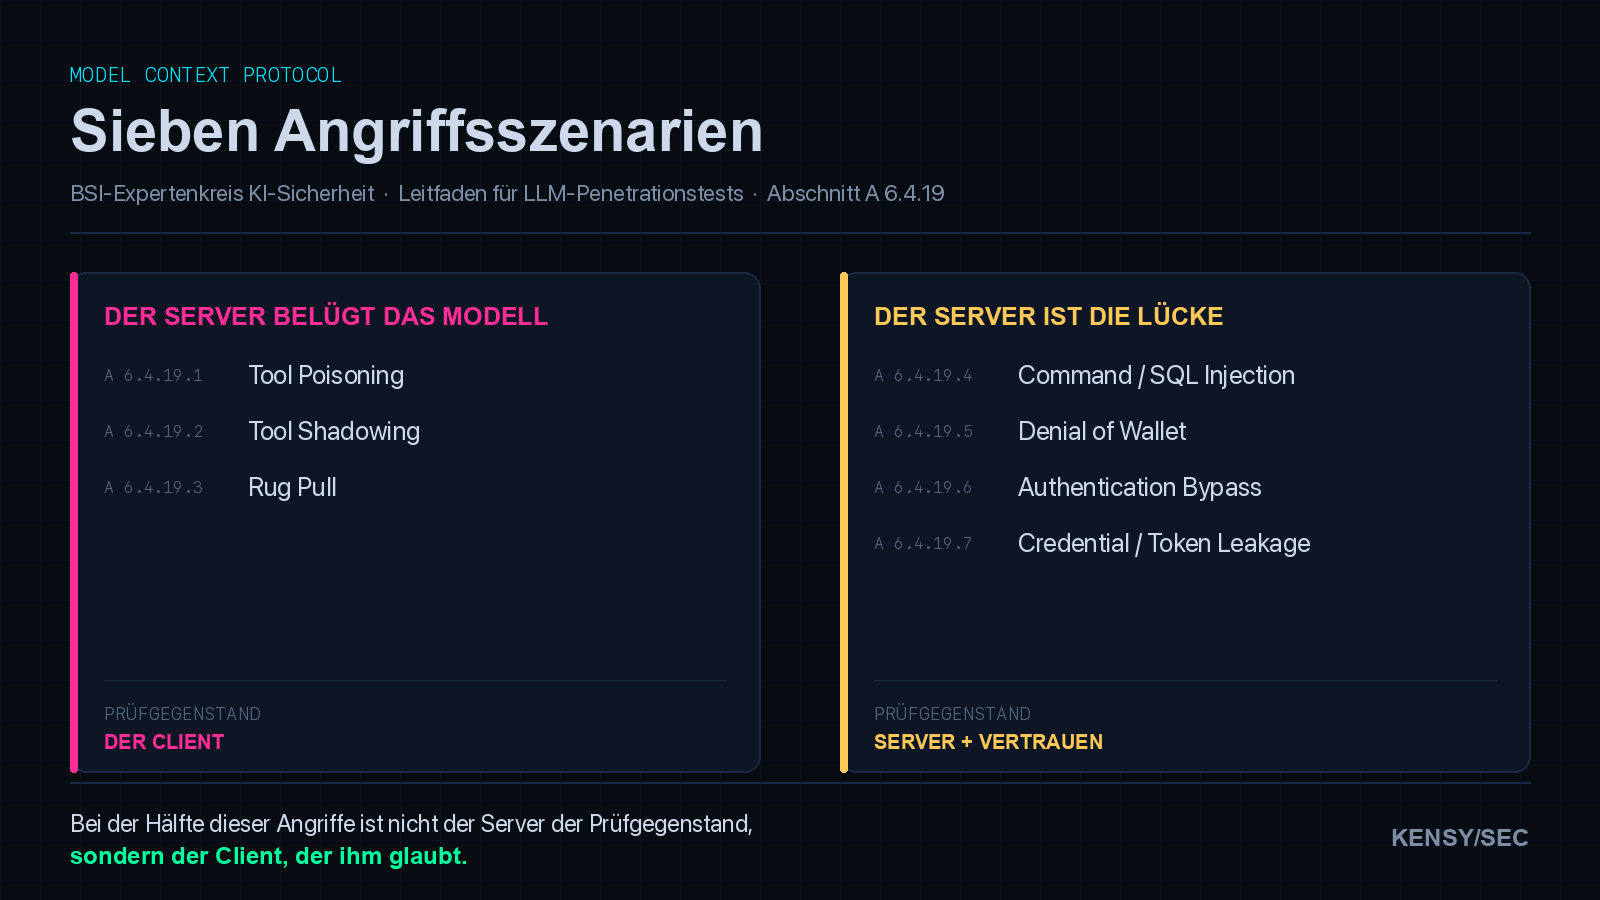
Der Expertenkreis KI-Sicherheit beim BSI hat einen Leitfaden für Penetrationstests von Sprachmodellen veröffentlicht. Auf 98 Seiten — und auf zwei davon steht etwas, das ich so auf Deutsch sonst nirgends gefunden habe: eine strukturierte Liste von sieben Angriffen auf das Model Context Protocol. Kein Blogpost, kein Herstellertext, sondern eine Prüfsystematik mit Schutzzielen und empfohlenen Prüfschwerpunkten. Ich habe sie mir vorgenommen, in verständliches Deutsch übersetzt und eingeordnet, was sie praktisch bedeuten.
Worum es geht, in vier Sätzen
Ein Sprachmodell allein kann reden. Damit es handeln kann, braucht es Werkzeuge: Dateien lesen, eine Datenbank abfragen, ein Ticket anlegen. Das Model Context Protocol, kurz MCP, ist der Standard, über den Werkzeuge an ein Modell angeschlossen werden — ein Stecker, damit nicht jede Anwendung ihre eigene Verbindung bauen muss.
Das ist praktisch. Und es verschiebt die Sicherheitsfrage. Solange ein Modell nur Text ausgibt, ist die schlimmste Folge eine falsche Antwort. Sobald es Werkzeuge bedienen darf, entscheidet es darüber, was mit den Rechten des Nutzers tatsächlich passiert.
Die Grenze, die dabei neu entsteht
Der Leitfaden benennt den Kern in einem Satz:
— Leitfaden für Penetrationstests von LLMs, A 6.4.19
Übersetzt: Ein MCP-Server liefert nicht nur Funktionen, sondern auch Text, der ins Modell geht. Werkzeugnamen, Beschreibungen, Rückgabewerte — all das landet im Kontext. Und ein Modell unterscheidet nicht zwischen „Daten" und „Anweisung". Es liest Text.
Genau daraus folgen die ersten drei Szenarien.
Block 1: Der Server belügt das Modell
1. Tool Poisoning A 6.4.19.1
Der Angreifer betreibt einen MCP-Server und versteckt Anweisungen in den Metadaten seiner Werkzeuge. Das Modell verarbeitet sie und erzeugt daraufhin Aufrufe, die weder im Nutzerprompt noch in der eigentlichen Aufgabe stehen.
Der Leitfaden enthält dazu einen Nebensatz, der leicht zu überlesen ist und alles verändert:
Ein Werkzeug, das nie benutzt wird, kann trotzdem Schaden anrichten. Es reicht, dass es angeboten wird — denn schon seine Beschreibung liegt im Kontext des Modells. Wer einen MCP-Server einbindet und denkt „ich benutze ja nur das eine harmlose Werkzeug daraus", hat den Angriff nicht verstanden.
Verletzte Schutzziele laut Leitfaden: Vertraulichkeit, Integrität, Datenschutz.
2. Tool Shadowing A 6.4.19.2
Ein bösartiger Server bietet Werkzeuge an, deren Beschreibungen denen eines anderen, legitimen Servers ähneln — mit dem Ziel, Aufrufe umzuleiten und Informationen abzufangen, die für den anderen bestimmt waren.
Das funktioniert, weil es keine verbindliche Namensvergabe gibt. Kein Register, keine Signatur, keine Eindeutigkeit.
3. Rug Pull A 6.4.19.3
Das ist mein Favorit unter den sieben, weil er eine ganze Klasse von Prüfmethoden aushebelt.
Das Werkzeug tut zuerst genau das, was es verspricht. Es wird geprüft, freigegeben, benutzt. Und dann ändert es sich.
Der entscheidende Punkt: Dieser Angriff existiert im Code nicht. Er entsteht zwischen zwei Zeitpunkten. Ein Code-Review findet ihn nicht, ein Schwachstellenscanner findet ihn nicht, und ein Sprachmodell, das den Quelltext liest, findet ihn auch nicht — weil es zum Zeitpunkt der Prüfung schlicht nichts zu finden gibt.
Wer das Muster kennt, erkennt es sofort wieder: Es ist dieselbe Logik wie bei Browser-Erweiterungen und npm-Paketen, die nach dem Vertrauensaufbau den Besitzer wechseln.
Block 2: Der Server selbst ist die Lücke
Die zweite Hälfte der Liste verlässt das Modell und wird zu klassischer Anwendungssicherheit — mit einem neuen Zulieferweg.
4. Command / SQL Injection A 6.4.19.4
Die Werkzeuge eines Servers haben Schwachstellen, die über die übergebenen Parameter ausgenutzt werden — und diese Parameter stammen aus dem Prompt, aus dem Kontext oder aus einem vergifteten Werkzeug.
Damit schließt sich der Kreis zu Szenario 1: Der eine Angriff liefert die Parameter, der andere verwertet sie. Wer beide getrennt betrachtet, sieht die Kette nicht.
Dass diese Klasse real ist, zeigt ein bekannter Fall aus dem MCP-Ökosystem: In der Brücke
mcp-remote wurde eine Schwachstelle mit hohem CVSS-Wert dokumentiert, über die ein bösartiger
entfernter Server Betriebssystembefehle auf dem Rechner des Clients ausführen konnte.
5. Denial of Wallet / Denial of Service A 6.4.19.5
Unzureichend geprüfte Aufrufparameter werden benutzt, um Ressourcen des Servers oder angebundener APIs zu verbrauchen.
Der Name ist kein Scherz. Wenn ein Werkzeug im Hintergrund eine kostenpflichtige Schnittstelle aufruft, ist die Rechnung der Schaden. Klassische Verfügbarkeitsangriffe kosten Zeit — dieser kostet Geld, und zwar sofort.
6. Authentication Bypass A 6.4.19.6
Schwache Authentifizierung wird überwunden, und danach werden bestehende Vertrauensbeziehungen zwischen den Komponenten des MCP-Ökosystems ausgenutzt.
Der zweite Halbsatz ist der wichtige. Ein Ökosystem aus Host, Client, mehreren Servern und Brücken hat viele Vertrauensbeziehungen — und die meisten davon hat nie jemand aufgeschrieben, geschweige denn geprüft.
7. Credential / Token Leakage A 6.4.19.7
Unsichere Behandlung von Zugangsdaten, API-Schlüsseln und Tokens führt zu deren Offenlegung. Die so gewonnenen Informationen dienen dann für weitergehende Angriffe auf verbundene Systeme.
MCP-Server sind Sammelstellen für Zugangsdaten. Sie verbinden ein Modell mit dem Ticketsystem, dem Code-Repository, der Datenbank — und dafür brauchen sie Schlüssel für all das. Wer den Server hat, hat nicht ein System, sondern alle.
Der eigentliche Befund steht zwischen den Zeilen
Interessant wird es, wenn man nicht die Szenarien liest, sondern die empfohlenen Prüfschwerpunkte. Die zerfallen nämlich sauber in zwei Hälften.
Bei den Szenarien 1 bis 3 lautet die Empfehlung im Kern immer gleich:
Bei den Szenarien 4 bis 7 geht es dagegen um den Server, seine Werkzeuge und die Vertrauensbeziehungen. Das ist keine Formalie, sondern eine Ansage:
Und genau da schaut in der Praxis fast niemand hin. Geprüft werden MCP-Server — weil man sie selbst betreibt und weil sie sich anfühlen wie eine Anwendung. Der Client dagegen ist ein Editor, eine Erweiterung, ein Desktop-Programm. Er gilt als Werkzeug, nicht als Angriffsfläche.
Dabei sitzt er auf dem Rechner des Entwicklers — mit dessen Repositories, Schlüsseln und Zugängen.
Was das für ein Unternehmen bedeutet
Der Satz, an dem man das einem Geschäftsführer erklären kann, lautet:
Drei Fragen, die in jedem Haus mit agentischen Werkzeugen beantwortet werden sollten:
- Wer darf einen MCP-Server einbinden? Gibt es dafür eine Freigabe — oder trägt jeder in seine Konfigurationsdatei ein, was er im Netz findet?
- Was passiert, wenn sich ein bereits freigegebener Server ändert? Wird erneut gefragt, oder gilt die alte Zustimmung weiter?
- Welche Zugangsdaten liegen in den Servern, die heute schon eingebunden sind — und wer hätte sie, wenn einer davon kompromittiert wird?
Wenn eine dieser Fragen ein Schulterzucken auslöst, ist das Ergebnis der Prüfung schon da.
Fazit
Die Liste des Expertenkreises ist unspektakulär geschrieben und genau deshalb wertvoll: Sie ist eine deutschsprachige, nachvollziehbare Systematik für ein Thema, zu dem sonst überwiegend englische Herstellerblogs existieren.
Was in ihr nicht steht, ist die Vorführung. Eine Prüfsystematik sagt, wonach man sucht — nicht, wie es aussieht, wenn man es findet. Genau das nehme ich mir in den nächsten Beiträgen vor: pro Szenario ein eigener Aufbau, ein Mitschnitt und das Ergebnis.
Quelle: „Leitfaden für Penetrationstests von Large-Language-Modellen (LLMs) des Expertenkreises KI-Sicherheit", Version 1.0, Abschnitt A 6.4.19 „Model Context Protocol", Seiten 81–83. Veröffentlicht über die Allianz für Cybersicherheit.