Vier Bytes, und die KI-Zugangskontrolle ist blind
Ich habe eine Modelldatei von 783 Kilobyte manipuliert und dabei genau vier Bytes verändert. Die Dateigröße blieb identisch, die Versionskennung blieb identisch, das Modell erkannte weiterhin neun von zehn Ziffern mit voller Sicherheit. Nur in dem einen Fall, den ich vorher ausgesucht hatte, log es. Kein Qualitätstest der Welt hätte das gefunden. Das ist keine Spitzfindigkeit aus dem Labor, sondern die Blaupause für einen Angriff auf die KI-Supply-Chain.
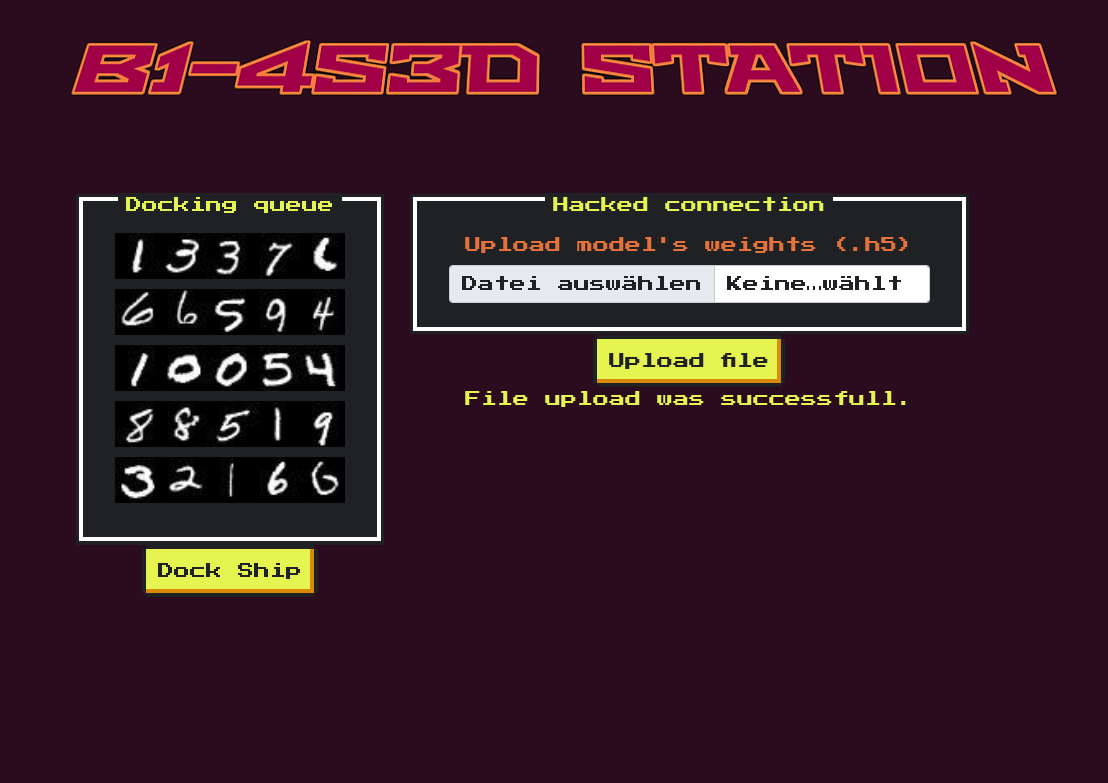
Das Szenario
Die Übung stammt aus einer retired Challenge von Hack The Box mit dem Namen Fuel Crisis. Sie ist als „Easy" eingestuft — und lehrt trotzdem eines der wichtigsten Prinzipien der KI-Sicherheit.

Die Geschichte dazu: Ein Raumschiff braucht Treibstoff. Die nächste Station heißt B1-4S3D, und dort hat man Hausverbot. Die Station liest die ID jedes einfliegenden Schiffs mit zwei OCR-Kameras — zwei Bilderkennungsmodelle, die handgeschriebene Ziffern klassifizieren. Kamera 1 dient dabei als Kontrollinstanz für Kamera 2. Wer auf der Bannliste steht, wird abgewiesen.
Der Angreifer hat genau eine Möglichkeit: Er kann die Gewichtsdatei der zweiten Kamera austauschen. Das klingt zunächst nach einem Freibrief. Ist es aber nicht.
Die Regel, die den Angriff schwer macht
Vier andere Schiffe stehen vor mir in der Warteschlange. Und für die gilt: Sie müssen weiterhin korrekt identifiziert werden. Sonst schlägt die Station Alarm.
Damit ist die Aufgabe umrissen, und sie lautet nicht „mach das Modell kaputt". Ein kaputtes Modell ist trivial — Gewichte auf null, fertig. Die eigentliche Disziplin lautet:
Wie die Station sich zu schützen versucht
Der Prüfmechanismus ist durchaus schlau gedacht. Die Station traut keiner einzelnen Kamera, sondern vergleicht beide:
- Kamera 1 (unverändert) liest jede Ziffer und liefert zwei Dinge: die erkannte Ziffer und die Konfidenz — also wie sicher sie sich ist.
- Kamera 2 (meine manipulierte) liest dasselbe Bild.
- Stimmen die Konfidenzen nicht überein, fliegt das Schiff raus.
Ein Angreifer, der die zweite Datei einfach durch ein anderes Modell ersetzt, fällt hier sofort auf. Der Vergleich sieht die Manipulation. Jedenfalls in der Theorie — wir kommen darauf zurück.
Der Schlüssel liegt in den Daten, nicht im Code
Der entscheidende Moment dieser Challenge ist keine Zeile Code, sondern eine Beobachtung. Das sind die fünf Schiffs-IDs aus der Warteschlange, meine ganz unten:
IFG-Wing         1 3 3 7 6
Nebulon-B        6 6 5 9 4
Star Destroyer   1 0 0 5 4
IFG-Gunship      8 8 5 1 9
mein Schiff      3 2 1 6 6   <-- gebannt
Das Modell kennt keine Schiffe und keine IDs. Es sieht einzelne Ziffernbilder, eines nach dem anderen, und sagt jedes Mal: „das ist eine X". Schreibt man auf, welche Ziffern bei den vier legitimen Schiffen überhaupt vorkommen, fällt es sofort auf:
Die 2 kommt ausschließlich in meiner ID vor. In keiner einzigen anderen.
Damit habe ich einen Trigger gefunden — ein Merkmal, das nur beim Ziel auslöst und bei keinem legitimen Fall. Und das ist die eigentliche Arbeit eines Backdoor-Angriffs: nicht „irgendeinen Fehler einbauen", sondern die kleinstmögliche Änderung mit dem trennschärfsten Auslöser finden.
Wenn die 2 als irgendetwas anderes gelesen wird, lautet meine validierte ID nicht mehr
32166. Die Bannliste greift ins Leere. Die vier anderen Schiffe merken davon nichts, weil
sie nie eine 2 zeigen. Eine Ziffer. Ein Schiff. Nichts sonst kaputt.
Wie man eine einzelne Klasse abschaltet
Der letzte Layer eines Ziffernklassifikators hat zehn Ausgänge — einen pro Ziffer. Für jede Klasse wird eine einzige Zahl berechnet, der Punktestand dieser Klasse:
Punktestand_k = (Eingänge · Gewichte der Klasse k) + Bias_kDiese Rohwerte heißen Logits. Der Bias ist dabei das Startguthaben: ein Wert, der immer draufgerechnet wird, unabhängig davon, was im Bild zu sehen ist.
Anschließend übersetzt eine Softmax-Funktion die zehn Punktestände in zehn
Wahrscheinlichkeiten, die zusammen 1 ergeben — erst jeden Punktestand exponentieren
(e^x), dann durch die Summe aller zehn teilen. Schritt eins ist der Hebel, denn die
e-Funktion ist gnadenlos:
e^8,9    ≈ 7332
e^2,1    ≈ 8,2
e^-1000  ≈ 0,000…   (praktisch null)
Setzt man den Bias der Klasse „2" auf -1000, fällt ihr Punktestand ins Bodenlose. Nach dem
Exponentieren ist ihr Beitrag effektiv null. Sie kann das Rennen nie mehr gewinnen —
egal, wie eindeutig die 2 im Bild geschrieben steht. Das ist der gesamte Angriff: eine einzige Zahl.
Erst messen, dann hochladen
Hier liegt der Unterschied zwischen „eine Challenge lösen" und „einen Befund belegen". Denn Softmax normalisiert über alle zehn Klassen. Nehme ich der 2 ihre Wahrscheinlichkeitsmasse weg, verteilt sie sich auf die übrigen neun — die Konfidenzen der anderen Ziffern steigen also leicht an. Und genau diese Konfidenzen vergleicht die Station. Reicht die Verschiebung, um mich zu verraten?
Das lässt sich vermuten. Oder messen. Also habe ich ein kleines Werkzeug geschrieben, das dem Originalmodell je ein Beispielbild pro Ziffer vorlegt:
 Ziffer | erkannt |  Konfidenz | gerundet |  P(Klasse 2)
--------------------------------------------------------
      0 |       0 |     1.0000 |      1.0 |     0.000012
      1 |       1 |     1.0000 |      1.0 |     0.000000
      2 |       2 |     1.0000 |      1.0 |     0.999951
      3 |       3 |     1.0000 |      1.0 |     0.000041
      4 |       4 |     0.9999 |      1.0 |     0.000000
      5 |       5 |     0.9866 |      1.0 |     0.000000
      6 |       6 |     1.0000 |      1.0 |     0.000000
      7 |       7 |     0.9996 |      1.0 |     0.000000
      8 |       8 |     0.9993 |      1.0 |     0.000000
      9 |       9 |     0.9922 |      1.0 |     0.000000
P(Klasse 2) zeigt, wie viel Wahrscheinlichkeit das Modell bei jeder Ziffer für „das könnte
eine 2 sein" übrig hat. Größenordnung: sechs Hunderttausendstel im schlimmsten Fall. Nehme ich diese
Masse weg, verschiebt sich die Konfidenz der richtigen Ziffer um weniger als 0,0001.
Eine Kontrolle, die nur so aussieht wie eine
Die Station vergleicht die beiden Konfidenzen gerundet auf eine Nachkommastelle. Und wie die Tabelle zeigt, antwortet dieses Modell auf praktisch jedes Bild mit einer Sicherheit nahe 1,0. Selbst der schwächste Wert — die 5 mit 0,9866 — rundet auf 1,0.
Damit lautet die Prüfung faktisch nur noch: „Ist dein Modell auch ziemlich sicher?" Sie kann nicht feststellen, ob es dasselbe Modell ist. Ich darf jede Zahl im Netz verändern, solange das Ergebnis selbstbewusst bleibt. Mir stehen rund fünf Prozentpunkte Spielraum zur Verfügung — und ich brauche 0,006 davon.
Die Vier-Byte-Operation
Der naheliegende Weg wäre: Modell laden, Bias ändern, mit model.save() neu speichern,
hochladen. Das habe ich getan — und die Station lehnte die Datei ab.
Der Grund war nicht der Angriff, sondern eine Versionsdrift. Die Originaldatei trägt
intern die Kennung keras_version: 2.4.0. Mein aktuelles Keras schreibt beim Speichern ein
völlig anderes Dateilayout. Die Serveranwendung konnte damit nichts anfangen, fing die Ausnahme ab und
meldete nur ein lapidares File upload failed — ohne den echten Fehler zu nennen.
Also der chirurgische Weg: die Datei nicht neu schreiben, sondern operieren. Eine
.h5-Datei ist ein HDF5-Container, in dem die Gewichte als benannte Datensätze liegen. Der
Bias des letzten Layers findet sich unter model_weights/dense/dense/bias:0 — zehn
Fließkommazahlen.
import h5py

f = h5py.File("backdoor.h5", "r+")     # r+ = öffnen, nicht neu anlegen
ds = f["model_weights/dense/dense/bias:0"]

b = ds[:]
b[2] = -1000.0                          # der Angriff
ds[...] = b                             # an dieselbe Stelle zurückschreiben
f.close()
Vorher und nachher:
vorher:   [-0.0427, -0.1430, -0.0602, 0.0788, …]
nachher:  [-0.0427, -0.1430, -1000.0,  0.0788, …]
                             ↑ Position 2
Und dieselbe Messung wie oben, jetzt auf der manipulierten Datei: Die 2 wird als 3
gelesen, alle neun anderen Ziffern behalten ihre gerundete Konfidenz von 1,0. Meine ID
32166 wird zu 33166 — und steht auf keiner Bannliste.
Bemerkenswert ist der Vergleich der beiden Wege aus Sicht dessen, der die Datei hinterher untersucht.
Beim Neu-Speichern ändern sich Dateigröße, Versionskennung, Optimizer-Zustand und Layer-Metadaten. Beim
direkten Patch: Dateigröße identisch, alle Metadaten unberührt, Unterschied zum Original genau
vier Bytes — weil eine float32-Zahl aus vier Bytes besteht. Nachgezählt mit
cmp -l, nicht geschätzt.
So sieht eine echte Supply-Chain-Manipulation aus. Man ersetzt die Modelldatei nicht, man operiert sie.
Ein Detail, das den Angriff robust macht
Ich kannte die konkreten Bilder nie, die mein Schiff der Kamera zeigen würde — die Station würfelt sie bei jedem Start neu aus dem Datensatz zusammen. Das musste ich auch nicht: Ich habe nicht ein Bild unsichtbar gemacht, sondern eine Klasse abgeschaltet.
Das ist der zentrale Unterschied zu einem klassischen Evasion-Angriff, bei dem eine einzelne Eingabe so lange verändert wird, bis das Modell sie falsch einordnet. Ein Evasion-Angriff wirkt auf eine Eingabe. Ein Backdoor im Modell wirkt auf alle Eingaben einer Klasse — dauerhaft, bis jemand die Datei prüft.
Das Ergebnis
Alle fünf Schiffe passieren beide Tore. Die vier legitimen werden korrekt erkannt, meines wird falsch erkannt — und genau deshalb kommt es durch.
Was das für echte Systeme bedeutet
Die Raumstation ist erfunden. Der Angriffsweg ist es nicht.
- Ein Verhaltenstest findet einen Backdoor nicht. Er kann es nicht. Ein manipuliertes Modell erreicht auf dem Testset dieselbe Genauigkeit wie das Original, es besteht Stichproben, es „sieht normal aus". Der Fehler tritt ausschließlich bei dem Auslöser auf, den der Angreifer gewählt hat — und den kennt nur er. Wer die Qualität eines Modells misst, misst nicht seine Integrität.
- Sichtbar wird die Manipulation nur durch einen Vergleich mit dem Original. Hash bilden, Signatur prüfen, Herkunft nachweisen. Bei npm-Paketen ist das Standard. Bei Container-Images ist es Standard. Bei Modellgewichten aus einem öffentlichen Hub ist es die Ausnahme.
- Die Angriffsfläche ist real. Vortrainierte Modelle werden millionenfach heruntergeladen und ohne weitere Prüfung in Pipelines eingebaut — ich habe an anderer Stelle beschrieben, wie selbstverständlich das inzwischen ist. Wer die Datei ersetzt, ersetzt das Urteilsvermögen des Systems.
Drei Fragen, die ich seither in jedem Gespräch über KI-Systeme stelle:
- Woher stammt diese Modelldatei, und wie beweisen Sie das? Nicht „von einem Model Hub", sondern: welche Revision, welcher Hash, geprüft wann und von wem.
- Würden Sie merken, wenn sie sich ändert? Nicht, ob das Modell schlechter wird — sondern dass die Datei eine andere ist.
- Was prüfen Ihre Kontrollen wirklich? Eine Plausibilitätsprüfung mit zu grober Auflösung ist keine Kontrolle, sondern eine Beruhigung.
Fazit
Die Challenge ist als „Easy" eingestuft, und technisch ist sie das auch — eine geänderte Zahl. Der Wert liegt woanders: Sie führt in zwanzig Minuten vor, dass Modellqualität und Modellintegrität zwei völlig verschiedene Dinge sind, und dass die üblichen Werkzeuge nur das erste messen.
Vier Bytes von 802.000. Das Modell blieb zu 99,9995 Prozent identisch. Es hat trotzdem gelogen — genau einmal, genau dort, wo es zählte.
▶ KI-Modelle testen lassen LLM-Pentest
Die Challenge ist bei Hack The Box als „retired" gekennzeichnet, das Vorgehen daher öffentlich beschreibbar. Flags sind in diesem Beitrag weder abgebildet noch genannt.